jitllm est un runtime d’inférence récent qui compile ses kernels pour le matériel disponible, répartit les blocs du modèle entre CPU et GPU et pagine poids et KV state entre plusieurs niveaux mémoire. Nous expliquons son fonctionnement, ses benchmarks publics et sa place face à vLLM.


jitllm est un nouveau runtime d’inférence LLM qui se présente comme un « système d’exploitation pour l’inférence LLM ». Son approche consiste à compiler les kernels à la volée pour la machine détectée, à répartir les blocs du modèle entre CPU et GPU et à paginer poids, experts et état KV entre plusieurs niveaux de mémoire.
Qu’est-ce que jitllm ?
jitllm est un moteur d’inférence LLM qui compile à l’exécution des kernels spécialisés pour le matériel détecté et organise le placement des blocs du modèle entre CPU, GPU et plusieurs niveaux de mémoire.
Sa documentation actuelle décrit un exécutable Go autonome, avec détection au runtime de CUDA, Vulkan et Metal, et sans dépendance Python, cgo ou SDK constructeur obligatoire côté application.
Le projet adopte volontairement une analogie avec les systèmes d’exploitation :
Concept système | Équivalent jitllm |
|---|---|
Processus | Un modèle chargé |
Thread | Une couche ou un bloc du modèle |
Scheduler | Placement des blocs entre périphériques |
Page physique | Bloc packagé dans un slot mémoire |
Page fault | Chargement d’un bloc demandé |
Exécutable | Conteneur de modèle .jlm |
Cette analogie n’est pas qu’un argument marketing. L’architecture du projet repose réellement sur compilation, placement, scheduling et paging.
Pourquoi jitllm est techniquement intéressant
1. Kernels compilés JIT
jitllm génère son code au chargement pour le processeur ou l’accélérateur détecté. La documentation cite notamment SSE, AVX2, VNNI et NEON côté CPU, puis PTX, SPIR-V et MSL côté GPU.
L’objectif est d’optimiser l’exécution pour la machine réellement disponible plutôt que de distribuer une stratégie de kernels identique à tous les environnements.
2. Placement dynamique entre appareils
Les blocs d’un modèle peuvent être répartis entre CPU et GPU. Le runtime peut déplacer ce placement selon la pression mémoire et le contexte d’exécution.
3. Paging entre VRAM, RAM et stockage
Le runtime peut paginer poids, experts MoE, pages KV et état récurrent. Cette approche est particulièrement intéressante lorsqu’un modèle dépasse la capacité d’un seul niveau mémoire.
4. API de serving standards
jitllm expose une API chat/completions compatible OpenAI, une API messages compatible Anthropic, ainsi qu’une Connect API destinée au contrôle des modèles, appareils, placements et sessions.
5. Un exécutable autonome
Le projet met en avant un exécutable autonome plutôt qu’un environnement Python lourd. Cela ne garantit pas automatiquement une meilleure exploitation, mais cela modifie clairement la surface de déploiement.
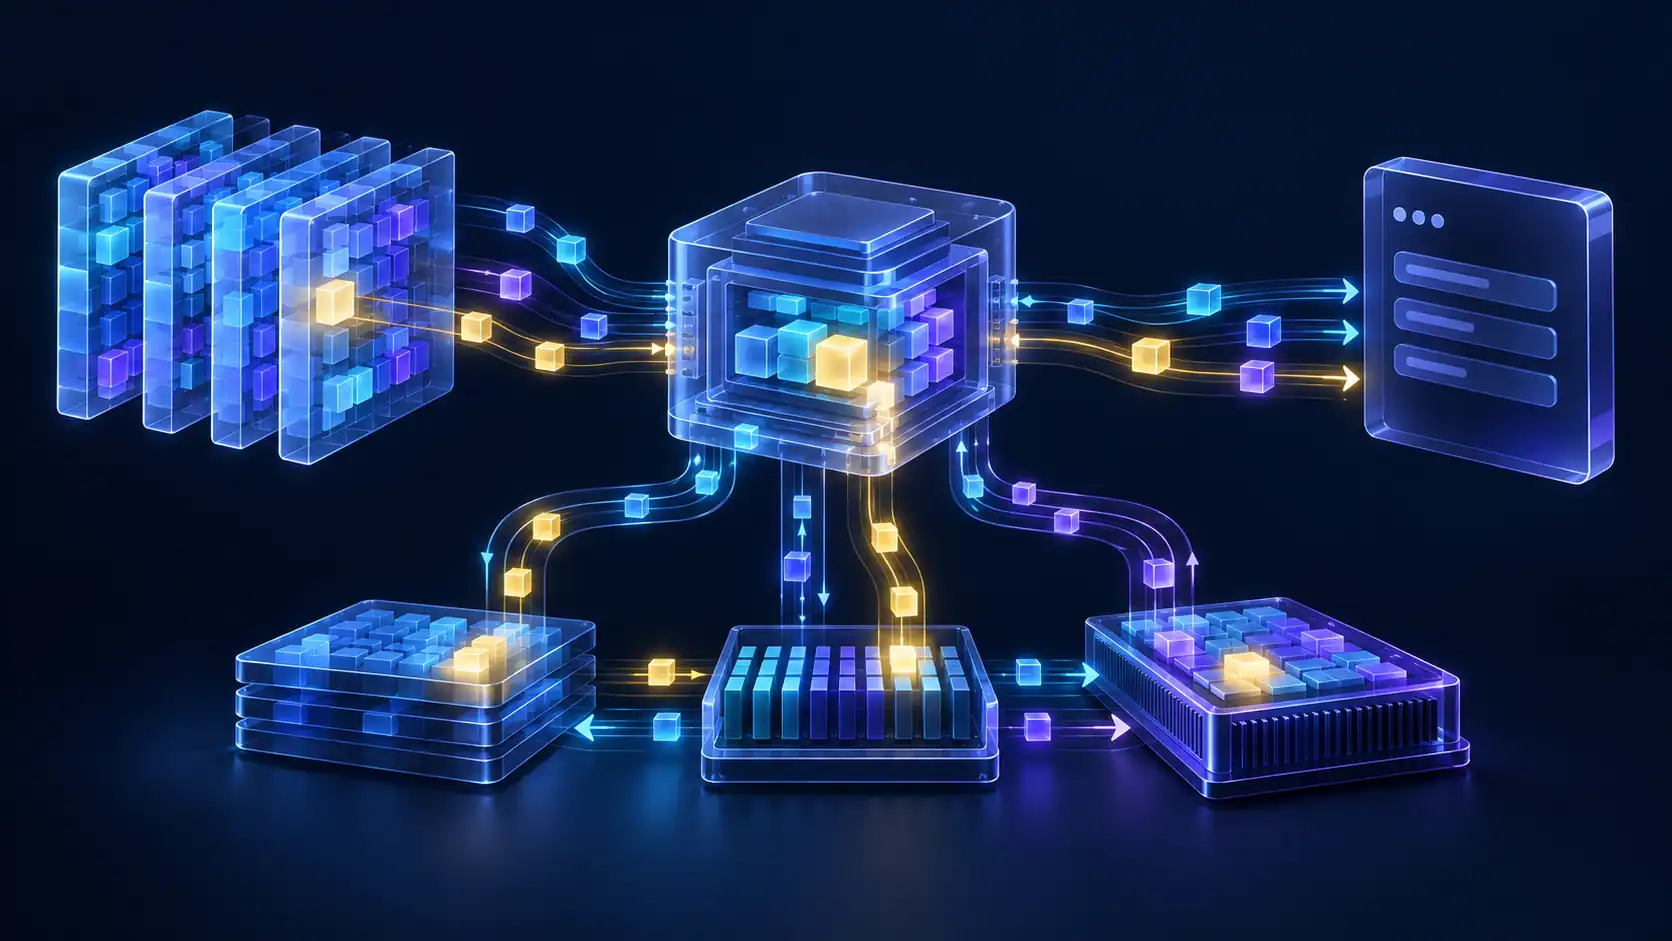
Comment fonctionne jitllm ?
Discover
Le runtime détecte les capacités CPU et les backends accélérateurs disponibles. CUDA, Vulkan et Metal peuvent être chargés au runtime.
Compile
jitllm génère des kernels adaptés aux formes du modèle, aux formats de poids et au matériel trouvé.
Schedule
Le runtime assigne les blocs du modèle à différents CPU ou GPU et peut répartir le travail sur plusieurs appareils.
Page
Poids, experts, KV cache et état peuvent être déplacés entre stockage, RAM et mémoire accélérateur en fonction des besoins.
Cette architecture rend jitllm particulièrement intéressant pour les machines hétérogènes et les environnements où la mémoire accélérateur est limitée.
Ce que nous avons testé
Notre prise en main s’est concentrée sur le chemin de serving, sans inventer de résultat de benchmark interne.
partir d’un modèle open source pris en charge ;
le charger ou le convertir via le chemin jitllm ;
laisser le runtime détecter le matériel disponible ;
servir le modèle via une API standard ;
observer comment le placement des devices et l’endpoint d’inférence peuvent se connecter à un runtime agentique de niveau supérieur.
Nous séparons volontairement cette validation pratique des benchmarks publiés par le projet. Si nous publions plus tard nos propres chiffres, ils devront inclure le GPU exact, le driver, le modèle, la quantification, la longueur de prompt, la concurrence et le build jitllm.
Benchmarks jitllm : que montrent réellement les chiffres publiés ?
Le projet publie plusieurs tableaux reproductibles et documente aussi certains cas où il perd face à llama.cpp ou d’autres runtimes. C’est un bon signal méthodologique : il évite de ne présenter que les résultats favorables.
Une comparaison publique utilise un NVIDIA Tesla V100-SXM2-16GB et Llama-3.1-8B-Instruct Q4_K_M. Dans cette configuration précise, jitllm publie les résultats suivants face à vLLM 0.18.1 sur le débit agrégé de décodage en batch :
Séquences concurrentes | jitllm tok/s | vLLM tok/s | Ratio publié |
|---|---|---|---|
16 | 955 | 394 | 2,42× |
32 | 1 288 | 415 | 3,11× |
64 | 1 860 | 436 | 4,27× |
128 | 2 440 | 441 | 5,53× |
Ces chiffres sont ceux publiés par jitllm, pas des mesures indépendantes réalisées par thaink². Ils constituent une hypothèse intéressante à reproduire, mais ne permettent pas d’affirmer que « jitllm est 5,53× plus rapide que vLLM » de manière générale.
Un autre résultat intéressant : le time to first token
La même page de benchmark publie le time to first token médian à chaud sur NVIDIA V100 pour plusieurs modèles et longueurs de prompts.
Pour Llama-3.1-8B avec un prompt d’environ 2 049 tokens, jitllm publie 556,8 ms, llama.cpp 652,8 ms et vLLM 4 292,7 ms dans cette configuration de test.
Là encore, ce n’est pas une affirmation universelle. Cela permet plutôt de formuler une hypothèse technique : la compilation JIT spécialisée et le modèle de placement de jitllm peuvent-ils réduire significativement le prefill/TTFT sur certains GPU plus anciens ou configurations hétérogènes ?
jitllm vs vLLM
Dimension | jitllm | vLLM |
|---|---|---|
Idée centrale | Compilation JIT + placement/paging inspiré d’un OS | PagedAttention + serving à haut débit |
Packaging | Binaires Go autonomes | Écosystème Python + composants natifs/CUDA et conteneurs |
CUDA | PTX généré au runtime et chargé via le driver | Support CUDA officiel avec binaires/images précompilés |
Autres GPU | Vulkan, Metal ; ROCm mentionné avec réserves | ROCm, XPU, Apple Silicon/plugins et autres backends |
Mémoire | Poids, experts et KV peuvent circuler entre niveaux mémoire | Optimisation du KV cache via PagedAttention |
API | OpenAI-compatible + Anthropic-compatible + Connect API | OpenAI-compatible et autres API de serving |
Maturité | Projet très récent | Écosystème largement établi |
La différence la plus importante aujourd’hui est probablement la maturité. vLLM dispose d’un écosystème très large, d’un catalogue de modèles important et de nombreux patterns de déploiement. jitllm est plus récent, mais explore une question différente : jusqu’où un moteur d’inférence peut-il s’adapter automatiquement au matériel réellement disponible ?
Pour une vue dédiée du moteur établi, voir Qu’est-ce que vLLM ?.
jitllm vs llama.cpp
Le site jitllm se compare largement à llama.cpp, notamment parce que les deux projets ciblent l’exécution locale ou auto-hébergée et prennent en charge des poids quantifiés.
jitllm publie plusieurs résultats favorables sur Tesla V100 tout en indiquant également des cas où llama.cpp ou MLX restent devant sur certaines charges Apple Metal ou CPU. Cette transparence renforce l’idée qu’il faut évaluer jitllm comme un runtime très sensible au matériel plutôt que comme un moteur systématiquement plus rapide.
Formats de modèles et compatibilité
jitllm peut convertir des modèles GGUF ou Hugging Face safetensors pris en charge vers son conteneur .jlm. Le projet liste actuellement de nombreuses familles : Llama, Qwen, Gemma, Phi, Mistral, architectures DeepSeek, modèles MoE, vision et embeddings.
La liste évolue rapidement. Pour un usage production, il faut vérifier précisément l’architecture, le checkpoint et les fonctionnalités nécessaires.
Faut-il installer le CUDA Toolkit ?
Selon la documentation actuelle de jitllm, les backends GPU sont chargés au runtime depuis les drivers présents sur la machine. Le runtime n’exige donc pas l’installation du CUDA Toolkit uniquement pour utiliser son backend CUDA.
Pour CUDA, jitllm génère du PTX au runtime puis le charge via le driver NVIDIA. Les performances finales dépendent toujours des capacités du GPU et du workload.
Où jitllm se place avec ApowerB
jitllm et ApowerB adressent des couches différentes mais complémentaires.
Couche | Responsabilité |
|---|---|
jitllm | Compiler et exécuter l’inférence sur le matériel disponible |
ApowerB | Gérer agents, sessions, outils, workflows et état |
thaink² | Fournir des expériences data, analytics et knowledge pour l’entreprise |
Un déploiement auto-hébergé peut donc utiliser jitllm comme endpoint d’inférence sous ApowerB, tout comme un autre déploiement pourrait utiliser vLLM ou une API managée.
Cette séparation est stratégique : le runtime agentique ne doit pas supposer qu’un seul moteur d’inférence gagnera sur toutes les générations de matériel.
Ce que nous testerions ensuite
même modèle et même quantification sur jitllm, vLLM et llama.cpp ;
TTFT sur prompts courts, moyens et longs ;
décodage mono-utilisateur et serving concurrent ;
comportement VRAM/RAM sous pression mémoire ;
placement multi-GPU ;
tool calling et structured output ;
temps de chargement et cold start ;
comportement lorsqu’un modèle dépasse la VRAM ;
restart et reprise derrière un runtime agentique.
Qui devrait surveiller jitllm ?
équipes exécutant des modèles open source sur matériel hétérogène ;
organisations cherchant à réduire les dépendances de déploiement ;
équipes voulant exploiter plus efficacement des accélérateurs plus anciens ou mixtes ;
déploiements de modèles dépassant un seul niveau mémoire ;
équipes auto-hébergeant l’inférence derrière des API standards ;
ingénieurs intéressés par la compilation JIT appliquée à l’inférence LLM.
Pour un système critique, la maturité, l’observabilité, la couverture des modèles et la reproductibilité des résultats restent aussi importantes que le débit brut.
Garder le moteur d’inférence remplaçable
ApowerB fournit la couche runtime open source autour des modèles afin que les agents, outils et états ne soient pas couplés à un seul backend d’inférence.
Notre avis après cette prise en main
jitllm est encore trop récent pour être présenté comme le remplacement par défaut d’un moteur établi. Mais son architecture est suffisamment différente pour mériter d’être testée dès maintenant.
Son idée la plus intéressante n’est pas un ratio de benchmark. C’est le modèle d’exécution : compiler pour la machine réellement présente, planifier les blocs du modèle comme un système d’exploitation planifie son travail et considérer VRAM, RAM et stockage comme des niveaux mémoire gérables par le runtime.
Pour cette prise en main, nous avons utilisé un GPU NVIDIA via le chemin CUDA pour faire tourner le serving du modèle. Avec jitllm, le runtime peut détecter le backend CUDA depuis le driver installé et générer du PTX pour le matériel au chargement. Nous ne transformons volontairement pas ce test en promesse universelle de performance : la prochaine étape logique serait une comparaison contrôlée avec le même modèle, les mêmes poids et le même GPU.
Faq
Qu’est-ce que jitllm ?
jitllm est un runtime d’inférence LLM qui compile les kernels pour le matériel détecté et organise le placement et le paging des blocs du modèle entre CPU, GPU et niveaux mémoire.
Quelle différence entre jitllm et vLLM ?
vLLM est un moteur de serving mature centré sur PagedAttention et le haut débit ; jitllm met davantage l’accent sur compilation JIT, placement des blocs et paging multi-device.
jitllm fonctionne-t-il avec les GPU NVIDIA ?
Oui. Son backend CUDA génère du PTX au runtime et utilise le driver NVIDIA installé ; le projet documente également Vulkan et Metal.
jitllm nécessite-t-il Python ?
La documentation actuelle présente son runtime sous forme de binaires autonomes ne nécessitant pas Python.
jitllm est-il plus rapide que vLLM ?
Le projet publie certains benchmarks favorables dans des configurations V100 précises, mais ces résultats ne doivent pas être généralisés sans test indépendant sur matériel et workload identiques.

