Jev est le premier modèle System One public de TypeSafe AI : un modèle conçu pour renvoyer des décisions probabilistes typées plutôt que du texte libre. Ce guide explique son fonctionnement, Noul, Choice et Score, ses différences avec les LLM, ses cas d’usage, ses limites et son évaluation en production.


Jev n’est pas un nouveau chatbot.
TypeSafe AI présente Jev comme le premier modèle public d’une nouvelle catégorie qu’elle appelle les System One Models : des modèles conçus pour prendre des décisions bornées et typées à l’intérieur d’un logiciel plutôt que pour générer du texte libre destiné à être lu par un humain.
La différence paraît subtile, mais elle change profondément l’interface entre l’intelligence artificielle et le code.
Un grand modèle de langage classique fonctionne généralement selon cette logique :
contexte → génération de tokens → texte, JSON, code ou appel d’outil
Jev est conçu autour d’un autre contrat :

état applicatif → questions typées → décisions probabilistes → action logicielle
L’application peut ensuite exploiter directement ces décisions pour router une requête, choisir un outil, évaluer un résultat, déclencher une escalade humaine ou appliquer une politique métier.
Cela ne signifie pas que Jev remplace GPT, Claude, Gemini ou les autres LLM.
La manière la plus utile de le comprendre est plutôt la suivante : Jev peut devenir une couche de décision spécialisée à côté du code déterministe, des systèmes de retrieval, des outils et des modèles génératifs.
Ce guide explique ce qu’est Jev AI, comment fonctionne le concept de modèle System One de TypeSafe AI, à quoi servent les primitives Noul, Choice et Score, quelles différences existent avec les LLM et les classifieurs traditionnels, où Jev peut s’intégrer dans une architecture d’agents IA, quelles sont ses limites et comment l’évaluer avant un déploiement en production.
Qu’est-ce que Jev AI ?
Jev est le premier modèle System One public de TypeSafe AI. Il est conçu pour renvoyer des décisions probabilistes typées plutôt que du texte généré librement.
TypeSafe AI a présenté Jev en septembre 2026 comme un modèle optimisé pour l’automatisation logicielle. Son interface accepte un state — l’état ou le contexte sur lequel la décision doit porter — ainsi qu’une ou plusieurs questions typées.
Le résultat est destiné à être consommé directement par le code de l’application.
Autrement dit, on ne demande pas principalement à Jev :
« Rédige une explication de ce qu’il faudrait faire. »
On lui demande plutôt :
« À partir de cet état, choisis l’une de ces options, évalue ce critère ou estime la probabilité que cette condition soit vraie. »
L’espace des sorties possibles est donc explicitement borné.
Jev AI, Jev IA, TypeSafe Jev : de quoi parle-t-on exactement ?
Plusieurs formulations commencent déjà à apparaître dans les recherches francophones : Jev AI, Jev IA, TypeSafe Jev, Jev TypeSafe AI, modèle Jev ou encore modèle System One.
Ces expressions renvoient au même produit : Jev, développé par TypeSafe AI.
Il ne faut pas le confondre avec les anciennes technologies portant le terme “Typesafe” dans l’écosystème Scala ou JVM. Ici, TypeSafe AI désigne l’entreprise à l’origine de Jev.
Qu’est-ce qu’un modèle System One ?
“System One Model” est le nom donné par TypeSafe AI à une catégorie de modèles conçus pour produire rapidement des décisions structurées exploitables directement par un logiciel.
Le terme est inspiré de la distinction popularisée entre pensée rapide et intuitive “System 1” et raisonnement plus lent et délibératif. Il faut néanmoins conserver une nuance importante : System One Model est aujourd’hui avant tout une catégorie définie par TypeSafe AI, et non un standard établi de l’industrie.
Critère | Jev / modèle System One | LLM généraliste |
|---|---|---|
Sortie principale | Décision typée et bornée | Séquence de tokens générés |
Destinataire naturel | Code applicatif | Humain ou système qui analyse la sortie |
Cas d’usage naturel | Classification, scoring, routing, sélection | Rédaction, raisonnement, synthèse, code |
Espace de sortie | Défini à l’avance | Potentiellement très large |
Probabilité / confiance | Éléments natifs du contrat | Pas nécessairement équivalents à une probabilité calibrée |
Texte libre | Pas le cas d’usage central | Capacité centrale |
Le point important n’est donc pas de déterminer quelle architecture est “meilleure”. Il est de reconnaître que plusieurs types d’intelligence peuvent coexister dans un même système.
Séparer le raisonnement des décisions opérationnelles bornées
thaink² aide les équipes à concevoir des workflows agentiques où modèles, outils, règles métier et validation humaine disposent chacun d’un rôle clairement défini.
Comment fonctionne Jev ?
À haut niveau, un appel à Jev contient trois éléments : State, les informations sur lesquelles la décision doit s’appuyer ; Questions, une ou plusieurs décisions bornées ; et Model, la version ou l’alias Jev utilisé.
Le schéma général devient :
état + questions typées → Jev → réponses typées + probabilités
La documentation publique de TypeSafe met en avant trois familles principales de questions : Noul, Choice et Score.
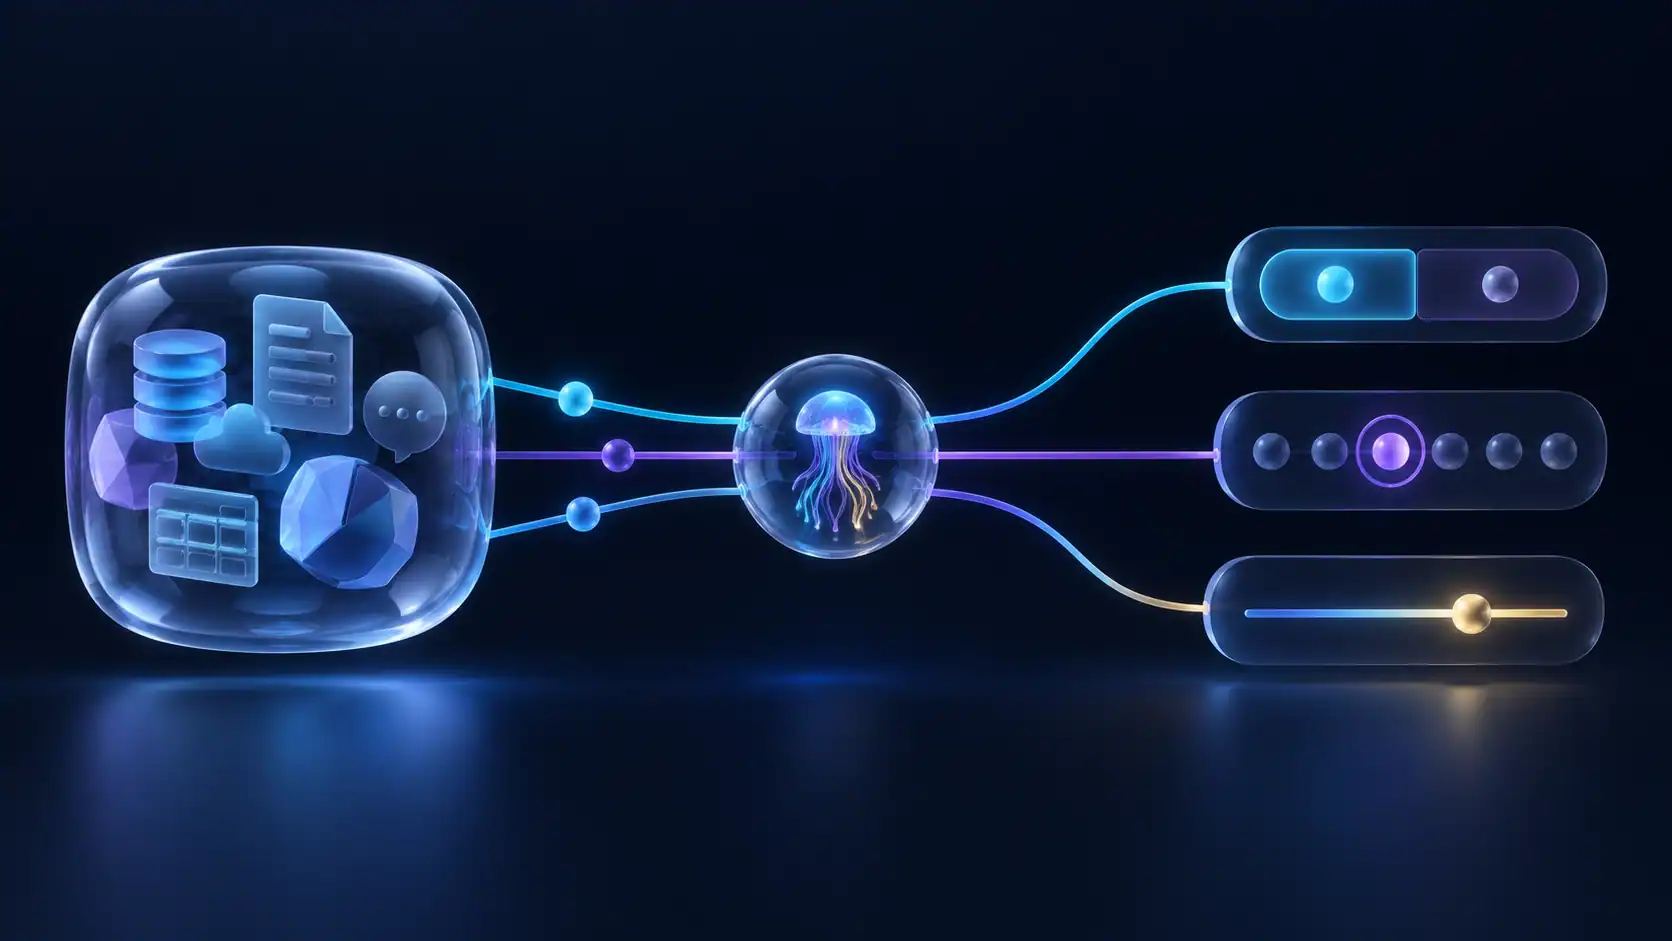
Noul, Choice et Score : les trois primitives de Jev
Noul : répondre à une question oui/non avec une probabilité
Noul représente un jugement binaire. Il peut par exemple estimer si une conversation nécessite une validation humaine, si une facture semble incohérente ou si une trace d’agent présente un risque de non-conformité.
Le résultat probabiliste permet au code d’appliquer une politique explicite : si p(validation_humaine) > 0,90 → escalade, si p(validation_humaine) < 0,20 → poursuite automatique, sinon un workflow intermédiaire.
Choice : choisir parmi un ensemble d’options autorisées
Choice sert lorsque le logiciel connaît déjà les actions valides et que le modèle doit sélectionner la plus adaptée : router vers Facturation, Support, Vente ou Validation humaine ; choisir un outil ; sélectionner une branche de workflow ; classer un incident.
Score : évaluer un élément sur une échelle
Score permet d’évaluer l’urgence d’un incident, la pertinence d’un document, le risque d’une action ou la qualité d’une exécution d’agent. Il est utile lorsque le problème possède davantage de nuances qu’un simple oui/non.
Pourquoi les décisions typées changent-elles l’intégration de l’IA ?
Une intégration LLM traditionnelle ressemble souvent à : prompt → texte généré → parsing → validation → retry éventuel → action logicielle.
Les sorties structurées ont déjà amélioré cette situation. Mais l’application utilise toujours un modèle génératif dont l’espace de capacités est parfois beaucoup plus large que la décision demandée.
La thèse de Jev est différente : état → jugement borné → valeur typée → action logicielle.
Cela peut réduire le parsing arbitraire, les labels invalides, les décisions cachées dans une longue explication et les règles métier noyées dans un prompt monolithique.
Cette séparation rejoint directement les principes développés dans notre guide sur la conception d’un runtime d’agent pour les workflows d’entreprise : en production, modèles, outils, état, permissions et exécution doivent disposer de frontières explicites.
Jev vs JSON mode : quelle différence avec les sorties structurées des LLM ?
Si GPT, Claude ou Gemini peuvent déjà renvoyer du JSON structuré, à quoi sert Jev ?
Critère | LLM avec sortie structurée | Jev |
|---|---|---|
Respect d’un schéma | Oui | Oui, dans son interface de décision |
Génération de texte libre | Oui | Pas le cœur du modèle |
Raisonnement ouvert | Oui | Pas le cas d’usage visé |
Espace de décision borné | Possible si le développeur le contraint | Principe central |
Probabilités de décision | Pas nécessairement équivalentes à une probabilité calibrée | Partie native de l’interface |
Meilleur usage | Raisonnement + génération structurée | Jugements étroits consommés par une machine |
Un LLM structuré reste plus approprié lorsque la tâche exige à la fois raisonnement et génération riche. Jev devient intéressant lorsque la prose n’apporte aucune valeur et que l’application a seulement besoin d’une décision bornée.
Jev peut-il halluciner ? La nuance essentielle
TypeSafe AI a beaucoup communiqué sur l’idée que Jev “ne peut pas halluciner”. Cette affirmation doit être interprétée précisément.
Le point défendu concerne surtout la validité structurelle de la sortie : Jev ne devrait pas inventer une réponse hors de l’espace typé défini.
Cela ne signifie pas que chaque décision est correcte.
Une sortie comme {"route": "facturation"} peut être parfaitement conforme au schéma tout en étant sémantiquement erronée.
Il faut donc distinguer erreur structurelle et erreur de décision. Une interface typée peut réduire la première, mais elle ne supprime pas la seconde.
C’est pourquoi l’observabilité de l’IA et l’évaluation restent indispensables.
Que signifie “confiance calibrée” ?
Une probabilité devient utile lorsqu’elle est suffisamment calibrée pour guider une politique. Dans un système bien calibré, un ensemble de décisions affichées autour de 80 % devrait être correct approximativement 80 % du temps sur un jeu d’évaluation comparable.
Les équipes doivent mesurer cette calibration sur leurs propres données. Le bon seuil dépend du risque métier : 90 % peut être acceptable pour router un ticket et insuffisant pour autoriser une opération financière importante.
Jev vs classifieur traditionnel
Un classifieur dédié peut rester meilleur lorsque les classes sont stables, qu’un grand dataset labellisé existe, que la latence doit être extrêmement faible ou que l’entreprise veut contrôler entièrement entraînement et déploiement.
Jev devient plus intéressant lorsque la décision nécessite une compréhension sémantique du contexte mais que la sortie doit rester bornée.
La vraie comparaison est souvent : code déterministe vs classifieur vs modèle de décision vs LLM génératif.
Jev vs règles métier déterministes
Une règle déterministe reste le meilleur outil lorsqu’une politique est elle-même déterministe. Si toute facture supérieure à 50 000 € nécessite une validation, écrivez cette règle dans le code.
Le modèle devient utile lorsque la condition nécessite une interprétation, par exemple déterminer si la description libre d’un achat entre en conflit avec celle d’une facture.
Code pour ce qui peut être explicitement déterminé ; modèle pour ce qui exige une interprétation sémantique.
Où Jev s’intègre-t-il dans une architecture d’agents IA ?
Jev devient particulièrement intéressant lorsqu’on le considère comme une brique d’un runtime agentique plutôt que comme un produit conversationnel autonome.
Un agent peut devoir décider quel workflow utiliser, quel outil appeler, si du retrieval est nécessaire, si une action est risquée, si un humain doit intervenir ou si le résultat final respecte un critère.
Toutes ces étapes ne sont pas des problèmes de génération.
Une architecture hybride peut ressembler à : requête → couche de décision → route → outil / retrieval / LLM → évaluation → accepter, relancer ou escalader.
Cette logique complète directement notre approche de l’orchestration des agents IA.

8 cas d’usage de Jev dans les agents IA et logiciels d’entreprise
1. Routing d’intention
Classer une demande dans un ensemble borné de workflows : facturation | support | vente | résiliation | validation_humaine.
2. Sélection d’outil
Choisir l’outil le plus pertinent dans un environnement agentique disposant de plusieurs capacités.
3. Escalade vers un humain
Estimer si un cas est trop ambigu, risqué ou atypique pour être traité automatiquement.
4. Évaluation d’une trace d’agent
Évaluer le respect d’une politique, la réussite d’une tâche, l’utilisation d’outils ou la nécessité d’une revue. Ce cas est directement adjacent à l’observabilité des agents IA.
5. Scoring de pertinence pour le retrieval
Évaluer si un passage récupéré est suffisamment pertinent pour entrer dans le contexte final.
6. Classification de politique
Déterminer quelle catégorie de politique s’applique avant que le code exécute les règles correspondantes.
7. Triage du risque
Évaluer l’urgence ou le risque avant de choisir un niveau de contrôle.
8. Évaluation d’une sortie générée
Séparer la génération de l’évaluation : un modèle produit, un autre jugement décide si le résultat peut avancer.
Quand ne pas utiliser Jev ?
Rédaction longue : Jev n’est pas conçu pour produire des articles ou conversations riches.
Raisonnement ouvert : si la tâche exige exploration et synthèse complexes, un LLM de raisonnement est plus naturel.
Génération de code : utilisez un modèle de code pour produire l’implémentation.
Règles métier exactes : gardez-les déterministes.
Décisions irréversibles à fort impact : une sortie typée ne rend pas le modèle infaillible ; contrôles et validation humaine restent nécessaires.
Performances, prix et latence de Jev : que sait-on réellement ?
TypeSafe positionne Jev sur la faible latence, le faible coût et l’efficacité sur les décisions bornées.
Au moment de cette rédaction, TypeSafe affiche un tarif de 0,042 $ par million de tokens d’entrée et une sortie gratuite. Cette tarification est susceptible d’évoluer.
Les benchmarks TypeSafe sont utiles pour comprendre le positionnement du produit mais restent des résultats fournisseur. Des évaluations indépendantes commencent à apparaître, notamment sur des tâches de classification, mais elles restent encore limitées en nombre et en diversité.
La conclusion raisonnable est : les caractéristiques économiques de Jev sont suffisamment prometteuses pour justifier un benchmark lorsque votre workflow effectue un volume important de décisions sémantiques bornées.
Jev fonctionne-t-il en français ?
La documentation publique de TypeSafe est principalement anglophone et les données indépendantes sur la performance spécifique de Jev en français restent limitées.
Pour un workflow francophone, construisez un jeu d’évaluation composé de formulations réelles, abréviations métier, fautes courantes, termes techniques anglais, cas ambigus et expressions propres à votre secteur.
La capacité à accepter du texte français et la capacité à être fiable dans votre domaine francophone sont deux questions différentes.
Comment évaluer Jev avant de l’utiliser en production ?
Étape 1 — Définir le contrat de décision
Définissez l’état disponible, les sorties autorisées, ce que signifie l’incertitude et l’action déclenchée par chaque résultat.
Étape 2 — Construire un jeu d’évaluation représentatif
Incluez cas simples, ambigus, rares, malformés et adversariaux lorsque pertinent.
Étape 3 — Comparer Jev aux vraies alternatives
Comparez règles actuelles, prompt LLM, LLM avec sortie structurée, classifieur dédié et Jev.
Étape 4 — Mesurer plus que l’accuracy
Mesurez precision, recall, matrice de confusion, calibration, cas incertains, distribution de latence, coût par décision, gravité des erreurs et stabilité après changement de version.
Étape 5 — Traiter les seuils comme une politique
Un seuil de confiance détermine ce que le logiciel a le droit de faire. Les seuils doivent dépendre du risque métier, pas d’une valeur par défaut générique.
Étape 6 — Réévaluer après chaque changement significatif
Version du modèle, formulation des questions, format du state, catégories et données amont peuvent tous modifier le comportement.
C’est l’une des raisons pour lesquelles l’IA d’entreprise a besoin d’une couche opérationnelle capable de suivre modèles, usage et évolution en production.
Mesurer les décisions avant de les transformer en automatisation
thaink² permet de superviser les agents en production, d’évaluer leur comportement et de mesurer l’impact des changements de modèles ou de workflows.
Checklist de mise en production d’un modèle de décision
1. Périmètre
La décision est-elle suffisamment étroite ?
Les résultats possibles sont-ils bornés ?
Doit-elle réellement être probabiliste ?
2. Données
L’état contient-il l’information nécessaire ?
Des permissions ou informations métier manquent-elles ?
Des données obsolètes peuvent-elles changer la bonne réponse ?
3. Évaluation
Avez-vous des exemples représentatifs labellisés ?
Mesurez-vous faux positifs et faux négatifs séparément ?
Avez-vous testé la calibration ?
4. Politique
Que se passe-t-il sous le seuil ?
Quels résultats exigent un humain ?
Quelles règles déterministes peuvent toujours bloquer ?
5. Observabilité
Peut-on reconstruire l’état et la décision ?
Comparer les performances par version ?
Transformer les erreurs en tests de régression ?
6. Gestion du changement
Que se passe-t-il lors d’une nouvelle version ?
Peut-on réaliser un shadow test ?
Existe-t-il un rollback ?

Jev et gouvernance des agents IA
Une décision typée peut faciliter la gouvernance parce que l’espace d’actions est explicite. Mais une entreprise doit toujours savoir quel modèle a décidé, quel état il a reçu, quelles options existaient, quelle confiance a été retournée, quel seuil a déclenché l’action et si un humain pouvait intervenir.
C’est la différence entre fiabilité du modèle et gouvernance du système.
Pour aller plus loin, consultez notre guide sur le framework de gouvernance des agents IA en entreprise.
Jev et AgentOps
Les décisions typées rendent l’observabilité plus structurée. Elles permettent de mesurer distribution des choix, confiance, taux d’escalade, automatisations erronées, désaccord avec les humains, latence, coût et régressions après mise à jour.
On passe ainsi de « l’agent s’est comporté bizarrement » à une métrique exploitable et comparable dans le temps.
Notre guide sur AgentOps, le monitoring et l’évaluation des agents IA détaille cette logique d’exploitation en production.
L’architecture la plus utile pourrait combiner Jev et les LLM
L’apparition de modèles de décision ne signifie pas la fin des modèles génératifs.
Une architecture hybride peut être plus robuste : Jev classe ou route → le code déterministe applique la politique → un LLM raisonne ou génère si nécessaire → une couche d’évaluation vérifie le résultat → le runtime accepte, relance ou escalade.
Cette séparation crée des frontières d’évaluation beaucoup plus propres.
Ce que Jev change et ce qu’il ne change pas
La question posée par Jev est simple : chaque étape intelligente d’un logiciel doit-elle être un problème de génération de texte ?
Pour le routing, la classification, la pertinence, le scoring, la sélection d’outil ou l’escalade, souvent non.
Mais données fiables, définition claire de la tâche, permissions, garde-fous déterministes, observabilité, versioning et escalade humaine restent nécessaires.
Où intervient thaink² ?
thaink² n’est pas construit autour d’un seul fournisseur ou d’une seule famille de modèles.
Notre approche porte sur la couche opérationnelle des agents IA : la manière dont données, modèles spécialisés, outils, workflows, évaluation et supervision fonctionnent ensemble.
Un modèle de décision comme Jev peut être pertinent lorsqu’un workflow contient un grand volume de jugements sémantiques avec un espace de sortie limité.
Un LLM génératif peut continuer à prendre en charge le raisonnement et la production de contenu. Le code déterministe doit continuer à contrôler les règles exactes. Les systèmes de retrieval doivent fournir les bonnes preuves. AgentOps doit continuer à mesurer le comportement en production.
L’architecture doit être conçue autour de la décision, pas autour d’une fidélité à un modèle.
Concevoir le runtime autour de la décision, pas autour d’un seul modèle
Construisez des agents d’entreprise où routing, outils, génération, évaluation et validation humaine utilisent chacun le composant adapté.
À retenir
Jev doit être compris comme une nouvelle option dans la stack IA, pas comme un remplacement universel des LLM.
Son approche devient particulièrement intéressante lorsque l’entrée exige une interprétation sémantique, que les résultats peuvent être bornés, qu’un logiciel doit agir sur la réponse et que l’incertitude peut être intégrée dans la politique métier.
Si la tâche est déterministe, utilisez du code. Si elle correspond à une classification stable avec beaucoup de données labellisées, comparez un classifieur spécialisé. Si elle exige du raisonnement ouvert ou de la génération, utilisez un LLM. Si elle correspond à une décision sémantique répétitive et bornée, Jev mérite d’être benchmarké.
L’IA d’entreprise n’a pas besoin d’un modèle qui fait tout. Elle a besoin de la bonne intelligence, au bon endroit, avec des responsabilités explicitement délimitées.
Faq
Qu’est-ce que Jev AI ?
Jev est le premier modèle System One public de TypeSafe AI. Il reçoit un état et des questions typées puis renvoie des décisions probabilistes bornées que le logiciel peut exploiter directement.
Qu’est-ce qu’un modèle System One ?
System One Model est le terme utilisé par TypeSafe AI pour des modèles optimisés pour des décisions rapides et structurées dans les logiciels plutôt que pour la génération de texte libre.
Quelle différence entre Jev et un LLM avec sortie JSON ?
Le JSON mode contraint la forme de sortie d’un modèle génératif. Jev est conçu spécifiquement autour de décisions bornées et de probabilités, tandis qu’un LLM structuré reste plus flexible pour les tâches combinant raisonnement et génération.
Jev peut-il prendre une mauvaise décision ?
Oui. Jev peut renvoyer une réponse parfaitement conforme au schéma mais sémantiquement incorrecte. L’évaluation, la calibration, les seuils de confiance, le monitoring et l’escalade humaine restent donc nécessaires.
Quels sont les meilleurs cas d’usage de Jev ?
Routing d’intention, sélection d’outil, classification, escalade humaine, triage du risque, scoring de pertinence et évaluation de sorties sont parmi les cas d’usage les plus naturels lorsque l’espace de décision est borné.
