
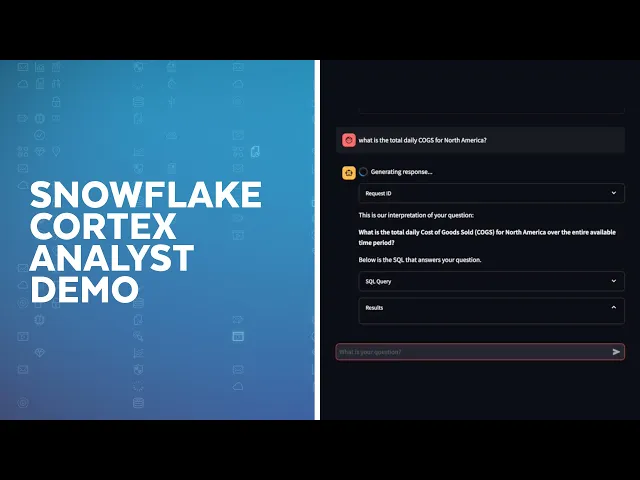
Le NLQ permet d’interroger les données métier avec des mots du quotidien. La difficulté n’est pas seulement de générer une requête, mais de comprendre les indicateurs, les permissions et le contexte pour produire une réponse fiable.

Aucun heading trouvé dans #cible
Une requête en langage naturel, ou NLQ, est une question formulée avec des mots du quotidien pour demander à un système de données de rechercher, filtrer, calculer ou analyser une information. Un utilisateur peut écrire « Quel était le chiffre d’affaires par région au dernier trimestre ? » au lieu de rédiger une requête SQL ou de parcourir un tableau de bord.
L’interface paraît simple. Le système qui se trouve derrière ne l’est pas.
Pour être fiable, le NLQ doit comprendre la question, relier le vocabulaire métier aux bons indicateurs et dimensions, respecter les permissions, construire la requête sous jacente, valider le résultat puis restituer une réponse compréhensible.
En production, la requête en langage naturel doit donc être pensée comme un workflow analytics gouverné, plutôt que comme une simple zone de chat placée devant une base de données.
Que signifie NLQ en analytics ?
En analytics, NLQ décrit la manière dont une personne formule sa demande. La requête est écrite ou prononcée en langage courant plutôt qu’avec un langage de requête formel.
Le système traduit ensuite cette intention en opérations que la plateforme de données peut exécuter.
Cette distinction est importante, car le NLQ est une interface, pas nécessairement une méthode d’exécution.
Une plateforme peut traduire la question en SQL. Une autre peut utiliser une couche sémantique, une API, un moteur de recherche ou plusieurs outils. L’expérience utilisateur peut sembler identique alors que l’architecture située derrière est très différente.
Cela explique aussi pourquoi le NLQ est plus large que le text to SQL.
Une question en langage naturel peut conduire à du SQL, mais aussi à une requête sémantique, une recherche, un graphique, une explication ou une succession d’étapes analytiques.
Pour le problème plus précis de traduction d’une question vers une base de données, la page text to SQL approfondit cette mécanique. Pour les workflows qui continuent après la première question, le sujet rejoint davantage les analytics agentiques.
Un exemple simple de requête en langage naturel
Imaginons qu’un responsable financier demande :

« Pourquoi la marge brute a t elle baissé en France le mois dernier ? »
Un système NLQ fiable ne peut pas simplement chercher des colonnes contenant les mots « marge », « France » et « mois ».
Il doit comprendre ce que signifie la marge brute dans cette entreprise, quelle définition de date est utilisée, quel champ géographique représente la France, si l’utilisateur peut accéder aux lignes concernées et quelle période de comparaison rend la question pertinente.
La question visible tient en une phrase.
Son interprétation analytique peut dépendre d’un modèle beaucoup plus riche de l’entreprise.
Comment fonctionne une requête en langage naturel ?
Les implémentations modernes diffèrent, mais un workflow de production contient généralement plusieurs étapes.
Interpréter la demande. Le système identifie l’intention de l’utilisateur, les entités, les mesures, les dimensions, les filtres et les références temporelles.
Résoudre le sens métier. Des termes comme chiffre d’affaires, client actif ou churn doivent correspondre à des définitions gouvernées et non à la colonne dont le nom semble simplement le plus proche.
Appliquer l’identité et les permissions. L’utilisateur ne doit pouvoir interroger que les données et indicateurs autorisés par l’architecture environnante.
Construire un plan de requête exécutable. Selon l’architecture, le système peut générer du SQL, appeler une couche sémantique, utiliser une API ou combiner plusieurs outils.
Valider puis exécuter. Le système vérifie que la demande est valide et sûre avant de l’exécuter sur la source de données concernée.
Restituer une réponse compréhensible. Le résultat final peut prendre la forme d’un nombre, d’un tableau, d’un graphique, d’une explication ou d’une nouvelle question analytique.

Les implémentations d’entreprise actuelles illustrent bien cette architecture.
Snowflake documente par exemple un fonctionnement dans lequel une question en langage naturel est interprétée à travers un modèle sémantique avant la génération de la requête.
Cette couche permet notamment de relier le vocabulaire utilisé par les équipes métier aux données réellement disponibles dans les systèmes.
NLQ, NLP, NLU, text to SQL et BI conversationnelle ne désignent pas la même chose
Ces termes apparaissent souvent ensemble alors qu’ils décrivent des couches différentes.
Concept | Ce qu’il décrit | Exemple |
|---|---|---|
Requête en langage naturel | L’utilisateur exprime une demande de données avec des mots courants | « Affiche le chiffre d’affaires par région au dernier trimestre » |
NLP | Le domaine général permettant aux logiciels de traiter le langage humain | Analyser les mots, la grammaire et le contexte |
NLU | L’interprétation du sens et de l’intention | Comprendre que « marge » correspond à un indicateur métier précis |
Text to SQL | Une méthode qui transforme le langage naturel en SQL | Convertir une question sur le chiffre d’affaires en requête SQL |
BI conversationnelle | Une expérience analytique fondée sur le dialogue et les questions successives | Demander, répondre, affiner, comparer puis visualiser |
Analytics agentiques | Un agent réalise un travail analytique sur plusieurs étapes ou dans le temps | Surveiller un KPI, investiguer un changement puis produire une explication |
Cette distinction permet d’éviter une erreur fréquente : penser qu’un meilleur modèle de langage produit automatiquement une meilleure analyse.
Un modèle peut parfaitement comprendre une phrase tout en sélectionnant le mauvais indicateur, la mauvaise jointure, la mauvaise période ou le mauvais contexte de permissions.
Pourquoi la couche sémantique est importante pour le NLQ en entreprise
Les questions les plus difficiles en entreprise le sont rarement à cause de la grammaire.
Elles le sont parce que le vocabulaire métier est ambigu.
« Chiffre d’affaires » peut désigner le chiffre d’affaires facturé, reconnu, net ou une définition propre à la direction financière.
« Client » peut représenter un compte, une entité de facturation ou un abonnement actif.
« Dernier trimestre » peut suivre l’année civile ou un calendrier fiscal spécifique.
Une couche sémantique fournit au système NLQ un contexte métier gouverné.
Elle peut définir les indicateurs, dimensions, relations, synonymes et règles d’accès afin que le système n’ait pas à reconstruire ou deviner la logique métier à chaque nouvelle question.
C’est pourquoi les architectures modernes de requête en langage naturel accordent une place importante à la sémantique.
Un grand modèle de langage peut comprendre une formulation. Il ne peut pas deviner de manière fiable toutes les conventions propres à l’entreprise.
Quelles questions peut on poser avec le NLQ ?
La meilleure manière de comprendre la requête en langage naturel est d’observer les questions métier qu’elle permet de traiter.
Le périmètre réel dépend toujours de la qualité du modèle de données, de la sémantique et des capacités de la plateforme.
Équipe | Question en langage naturel | Ce que le système doit comprendre |
|---|---|---|
Finance | « Quelles catégories de coûts expliquent l’écart par rapport au budget ce mois ci ? » | Budget, réalisé, écart, période, catégories et droits d’accès |
Ventes | « Quelles opportunités entreprise risquent le plus de manquer le trimestre ? » | Étape commerciale, segment, date de clôture, forecast et pipeline |
Opérations | « Où le délai de traitement a t il le plus augmenté cette semaine ? » | Indicateur de délai, période, sites et base de comparaison |
Produit | « Comment l’adoption de cette fonctionnalité a t elle évolué après la dernière version ? » | Événement produit, utilisateurs concernés, date et indicateur d’adoption |
Les questions simples peuvent parfois être traitées avec une seule requête.
Les demandes plus ambiguës peuvent nécessiter une clarification, plusieurs requêtes ou un workflow analytique plus profond.
Un bon système doit donc savoir quand il dispose d’un contexte suffisant et quand il doit demander à l’utilisateur de préciser sa question.
Où la requête en langage naturel crée le plus de valeur
Le NLQ est particulièrement utile lorsque les utilisateurs connaissent leur question métier mais ne veulent pas que la mécanique d’accès aux données devienne le principal obstacle.
Il peut réduire les demandes répétitives adressées aux équipes data, rendre l’exploration ponctuelle plus accessible et diminuer le temps entre une question et les premiers éléments de réponse.
Il fonctionne particulièrement bien lorsque les indicateurs sont clairement définis, les dimensions maîtrisées et les schémas d’analyse relativement récurrents.
Le NLQ peut également améliorer l’utilisation d’un environnement de business intelligence existant.
Un tableau de bord est excellent lorsque la question a été anticipée.
La requête en langage naturel devient particulièrement utile lorsque la prochaine question ne l’a pas été.
Cela ne signifie pas que toutes les analyses complexes doivent devenir accessibles en libre service.
Les analystes restent essentiels lorsqu’un problème nécessite une nouvelle modélisation, un raisonnement causal, un protocole expérimental, une expertise métier ou une investigation à partir d’informations incomplètes.
Pourquoi certaines expériences NLQ échouent
Une interface en langage naturel peut donner à une base de données fragile une apparence trompeuse de simplicité.
C’est l’un des principaux risques.
Le système peut produire une requête techniquement valide qui répond à la mauvaise question métier.
Il peut sélectionner le mauvais indicateur, joindre des tables incompatibles, mal interpréter une période, exposer des données auxquelles l’utilisateur ne devrait pas accéder ou résumer avec assurance un résultat mal validé.
Les principaux échecs ne concernent donc pas uniquement la compréhension du langage.
Ils incluent notamment les erreurs sémantiques, la qualité des données, les permissions, la logique de requête et les explications trompeuses.
Un système NLQ fiable doit donc être évalué comme un système analytique, pas simplement comme une interface conversationnelle.
Comment sécuriser le NLQ en entreprise ?
Le modèle de langage ne devrait jamais devenir l’autorité qui décide quelles lignes, tables ou applications un utilisateur peut consulter.
Les permissions doivent être appliquées par l’architecture data et applicative environnante.
Selon la sensibilité du workflow, les contrôles peuvent inclure :
des accès par rôle, la sécurité au niveau des lignes, une exécution en lecture seule, des limites de requête, des schémas restreints, des journaux d’audit et une validation explicite avant certaines actions sensibles.
La sécurité concerne également les requêtes générées.
Un système peut inspecter la demande utilisateur puis la requête produite avant de l’exécuter.
Le principe est essentiel : une requête générée par une IA reste une sortie à valider. Elle ne devient pas automatiquement sûre parce qu’elle provient d’un modèle.
Comment évaluer la qualité d’un système NLQ ?
Une requête réussie n’est pas simplement une requête qui s’exécute sans erreur.
La justesse métier compte davantage.
Le système a t il choisi le bon indicateur ?
A t il compris la population réellement demandée ?
A t il utilisé la bonne période ?
A t il respecté les autorisations ?
L’utilisateur peut il comprendre d’où provient le résultat ?
Un programme d’évaluation sérieux devrait mesurer plusieurs dimensions :
la précision de l’interprétation, l’exactitude de la requête, l’exactitude de la réponse, le respect des permissions, la traçabilité, la latence et la capacité du système à gérer l’ambiguïté.
Les équipes devraient également conserver des questions réellement posées par leurs utilisateurs.
Un benchmark construit uniquement à partir de démonstrations propres risque de surestimer largement les performances lorsque les équipes commencent à utiliser du vocabulaire interne, des abréviations et des formulations incomplètes.
Des mécanismes de requêtes vérifiées peuvent également être utilisés pour associer certaines questions récurrentes à des modèles analytiques déjà validés.
L’objectif n’est pas de supprimer l’intelligence du système.
Il est d’augmenter la confiance lorsque certaines questions métier se répètent.
Le NLQ remplace t il les tableaux de bord ou les analystes data ?
Dans la majorité des cas, non.
Les tableaux de bord restent particulièrement utiles pour le suivi régulier, les KPI partagés et les vues récurrentes.
Le NLQ convient davantage à l’exploration lorsqu’un utilisateur pose une question qui n’avait pas été anticipée dans le tableau de bord.
Les analystes data restent eux aussi essentiels pour les travaux complexes, notamment lorsque le problème nécessite de nouveaux modèles, une investigation profonde ou un jugement sur des éléments incomplets.
La requête en langage naturel peut réduire certaines tâches répétitives de récupération d’informations et accélérer la première phase d’analyse.
Elle ne remplace pas l’expertise analytique.
Le modèle le plus robuste est souvent complémentaire :
tableaux de bord pour le monitoring connu, NLQ pour les questions ponctuelles et agents analytiques pour les workflows qui doivent continuer sur plusieurs étapes.
Où s’arrête le NLQ et où commencent les analytics agentiques ?
Une requête en langage naturel commence généralement par une personne qui pose une question.
Un agent analytique peut aller plus loin.
Imaginons qu’un utilisateur demande :
« Pourquoi la conversion a t elle baissé hier ? »
Le NLQ peut interpréter la question et récupérer les premières données pertinentes.
Un workflow agentique peut ensuite déterminer que cette première réponse ne suffit pas, comparer différents canaux, examiner les régions, analyser les segments produit, rechercher du contexte supplémentaire puis construire une explication.
La différence ne vient pas du fait que l’un utilise le langage naturel et l’autre non.
Elle vient de l’étendue du travail confié au système.
Le NLQ fournit une interface permettant de poser une question.
Les analytics agentiques ajoutent la capacité d’investiguer, d’enchaîner plusieurs outils, de conserver le contexte et éventuellement de répéter une mission analytique lorsqu’une condition précise est remplie.

Que faut il rechercher dans un outil de requête en langage naturel ?
Les critères les plus importants ne sont ni la qualité de l’animation de démonstration ni la fluidité avec laquelle l’assistant rédige ses réponses.
Commencez par vérifier si le système comprend réellement votre métier.
Comment les indicateurs sont ils définis ?
Comment les synonymes et les relations sont ils gérés ?
Comment les permissions sont elles héritées ?
L’utilisateur peut il vérifier ce que le système a réellement interrogé ?
Testez ensuite l’ambiguïté.
Utilisez du vocabulaire interne, des périodes relatives, plusieurs définitions possibles d’un même indicateur et des questions successives.
Une interface fiable doit savoir clarifier l’incertitude au lieu de la masquer.
Enfin, évaluez ce qui se passe après la première réponse.
L’utilisateur peut il examiner le résultat ?
Peut il poser une nouvelle question ?
Peut il poursuivre l’investigation sans perdre le contexte ?
Peut il comprendre pourquoi le système est arrivé à cette conclusion ?
Dans de nombreux cas, ces capacités comptent davantage que la qualité brute de génération du texte.
Comment thaink² utilise le langage naturel pour l’analyse de données
Dans thaink², le langage naturel fait partie du modèle d’interaction du Data Analyst Agent.
L’objectif n’est pas uniquement de transformer une phrase en SQL.
Il s’agit de relier une question métier aux données pertinentes de l’entreprise, d’effectuer l’analyse appropriée puis de restituer un résultat compréhensible.
Lorsque des données structurées doivent être interrogées, le text to SQL peut représenter une étape du workflow.
Lorsque l’investigation nécessite plusieurs étapes analytiques, ce même travail peut évoluer vers les analytics agentiques.
Cette distinction est importante.
La requête en langage naturel facilite la formulation de la question. Un agent analytique spécialisé prend en charge une partie plus importante du travail qui commence après cette question.
À retenir
La requête en langage naturel devient progressivement une interface importante de l’analytics moderne parce qu’elle réduit la friction technique entre une question métier et les données nécessaires pour y répondre.
Mais le NLQ en entreprise ne se résume pas à « une phrase entre, du SQL sort ».
Les systèmes réellement fiables ont besoin de sémantique métier, d’accès gouvernés, de validation, de traçabilité et d’une manière explicite de gérer l’ambiguïté.
Les organisations qui tireront le plus de valeur du NLQ ne seront donc probablement pas celles qui supprimeront toutes les couches entre les utilisateurs et les données brutes.
Ce seront celles qui réussiront à rendre ces couches presque invisibles pour l’utilisateur tout en les maintenant explicites, contrôlées et vérifiables dans l’architecture.
Faq
Qu’est ce qu’une requête en langage naturel ?
Une requête en langage naturel est une demande écrite ou prononcée avec des mots courants pour demander à un système de données de rechercher, filtrer, calculer ou analyser une information sans obliger l’utilisateur à écrire un langage de requête formel.
Comment fonctionne une requête en langage naturel ?
Un système NLQ interprète l’intention de l’utilisateur, relie les termes métier aux concepts de données appropriés, applique les permissions, construit une requête ou un appel d’outil exécutable, le valide puis restitue le résultat sous une forme compréhensible.
Quelle est la différence entre NLQ et text to SQL ?
NLQ décrit la demande et l’interface en langage naturel. Text to SQL est une méthode d’exécution possible qui transforme cette demande en SQL. Un système NLQ peut également utiliser des requêtes sémantiques, des API, de la recherche ou plusieurs outils.
Le NLQ est il sécurisé pour les données d’entreprise ?
Il peut l’être si les contrôles d’accès sont appliqués par l’architecture data environnante. Une implémentation en entreprise doit utiliser des permissions gouvernées, une exécution restreinte, de l’audit et de la validation plutôt que de laisser le modèle décider seul des données accessibles.
Le NLQ remplace t il les tableaux de bord ou les analystes data ?
Généralement non. Les tableaux de bord restent utiles pour le suivi récurrent et les analystes pour les travaux complexes. Le NLQ apporte surtout de la valeur pour l’exploration ponctuelle et comme interface au sein de workflows analytiques plus larges.
