Persister l’historique d’un chat ne suffit pas à reprendre un agent IA en sécurité. Il faut distinguer mémoire, état du workflow, historique d’exécution et effets métier pour éviter l’amnésie ou la répétition d’actions après un crash.


La mémoire d’un agent IA et son état d’exécution ne sont pas la même chose. Les confondre peut rendre la reprise dangereuse.
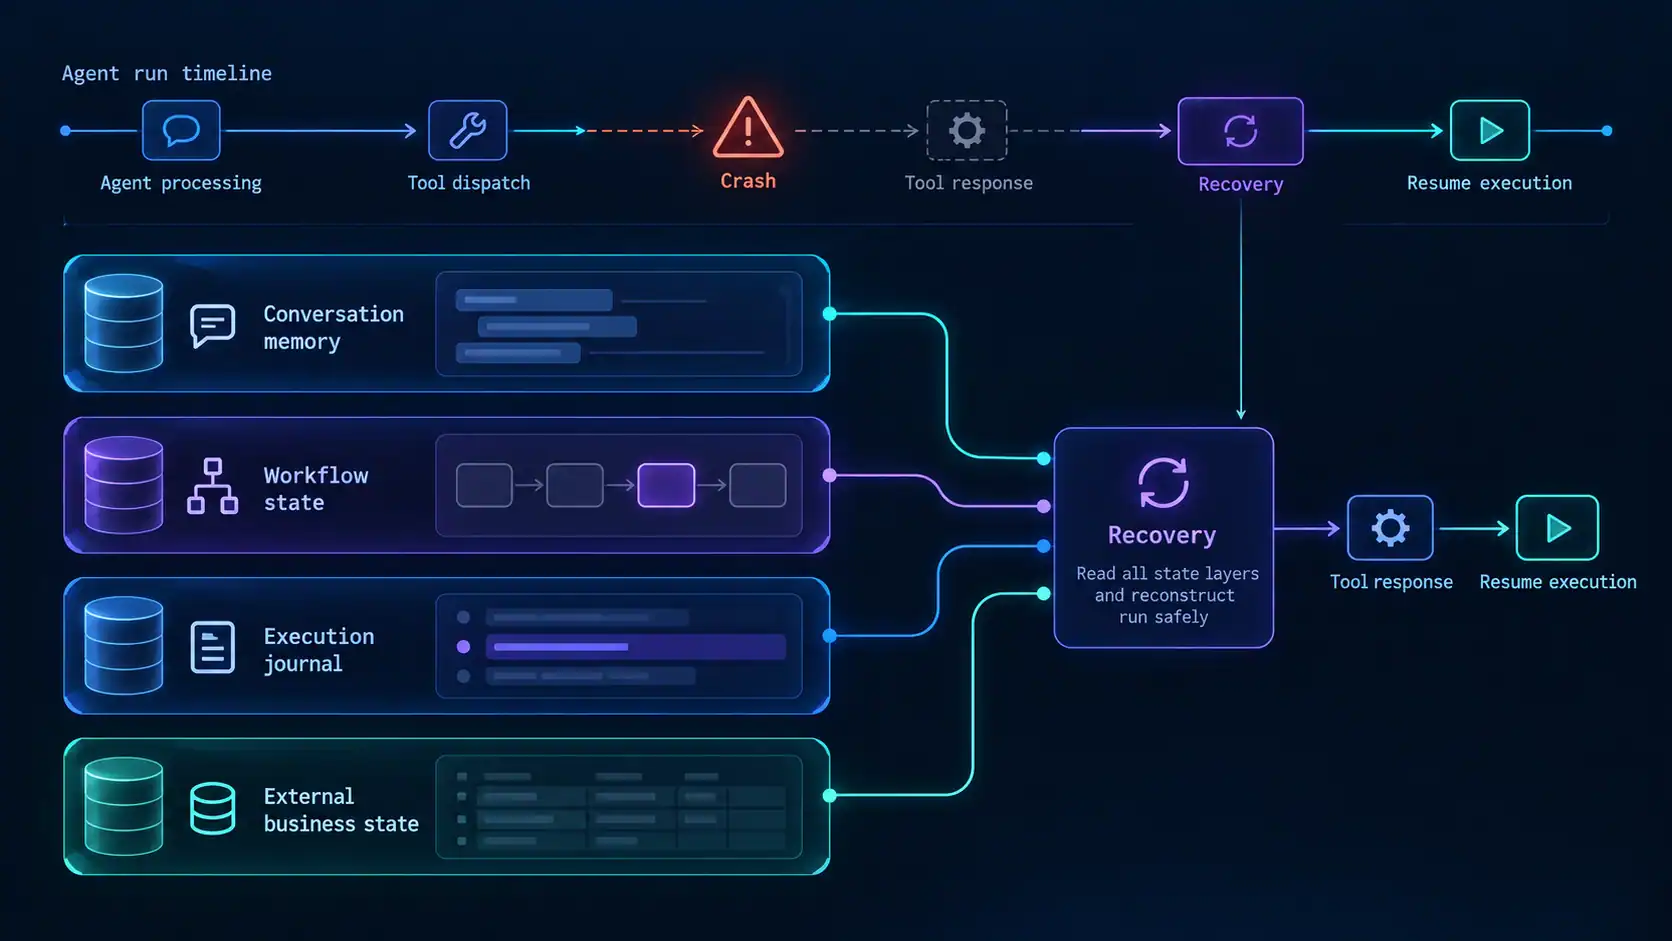
Une conversation peut survivre à un redémarrage alors que le workflow reste impossible à reprendre proprement. Un run peut avoir d’excellentes traces tout en ayant perdu l’entrée nécessaire à sa reconstruction. Et un agent “récupéré” peut renvoyer un email ou répéter une écriture qui avait déjà été exécutée avant le crash.
Ce guide sépare quatre notions : mémoire conversationnelle, état du workflow, historique d’exécution et effets métier externes. Il s’appuie sur les incidents rencontrés avec ApowerB sans reproduire l’article DEV.to “Amnesia and Déjà Vu”.
Qu’est-ce que la gestion de l’état d’un agent IA ?
La gestion de l’état d’un agent IA consiste à persister les informations nécessaires pour comprendre, poursuivre, rejouer ou arrêter correctement un run indépendamment du processus qui l’exécute.
Cela peut inclure :
run ID et entrée d’origine ;
statut courant ;
référence de session ;
position du workflow ;
tool calls et résultats ;
approbations humaines ;
identifiants externes et clés d’idempotence ;
erreurs et métadonnées de retry.
Mémoire, état, historique d’exécution et état métier
Concept | Question | Exemple |
|---|---|---|
Mémoire conversationnelle | Qu’ont dit l’utilisateur et l’agent ? | Messages et événements modèle |
Mémoire long terme | Que doit retenir l’agent entre deux sessions ? | Préférence ou fait appris |
État du workflow | Où en est ce run ? | Running, waiting for approval, failed |
Historique d’exécution | Qu’a tenté le runtime ? | Tool calls, sorties, timestamps |
État métier | Qu’est-ce qui est maintenant vrai à l’extérieur ? | Email envoyé, remboursement effectué, CRM modifié |
Le transcript aide à comprendre l’intention. Il n’est pas un registre fiable des effets externes.
Échec n°1 : l’amnésie après redémarrage
En développement, une session en mémoire locale est pratique. En production, le processus est jetable.
Lors d’un audit interne ApowerB, environ 8 redémarrages applicatifs par jour étaient observés entre déploiements et activité normale du cluster. Si les sessions résident dans la RAM du processus, chaque restart peut effacer le contexte.
La correction consiste à déplacer hors du processus tout état qui doit lui survivre.
Persister la mémoire ne rend pas le run reprenable
Une conversation stockée en base permet au worker suivant de retrouver les échanges. Elle ne dit pas forcément :
quelle étape runtime était terminée ;
quel appel outil avait déjà quitté le processus ;
si le système externe avait effectivement écrit ;
si l’action pouvait être rejouée sans risque.
Il faut donc un run record distinct de la mémoire conversationnelle.
Échec n°2 : le run disparaît, mais l’effet externe reste
Prenons un agent support :
lire la demande ;
préparer la réponse ;
envoyer l’email ;
mettre à jour le CRM.
Si le processus tombe entre les étapes 3 et 4, un replay depuis zéro peut envoyer le même email deux fois.
C’est la version production du “déjà vu” : le runtime ne sait plus exactement où il s’est arrêté, mais le monde extérieur se souvient de ce qui s’est déjà produit.
Pourquoi “reprendre à l’étape 3” est plus difficile avec un LLM
Dans un workflow déterministe, les étapes sont stables. Dans un workflow agentique, le modèle peut prendre un chemin différent après replay à cause du contexte, du provider, de la version du modèle ou des sorties intermédiaires.
Les checkpoints doivent donc représenter des transitions validées et des effets externes connus, pas de simples “étapes de raisonnement”.
Décider si un replay est sûr
L’entrée d’origine existe-t-elle ?
Les appels d’outils sont-ils journalisés ?
Peut-on prouver que répéter l’action est sans risque ou dédupliqué ?
Si la troisième réponse est “inconnue”, l’automatisation doit généralement s’arrêter.

Classer les outils selon le risque de replay
Classe | Exemple | Politique par défaut |
|---|---|---|
Lecture seule | Lire une fiche client | Généralement rejouable |
Écriture idempotente | PUT avec identifiant stable | Rejouable si l’idempotence est garantie |
Événement dédupliqué | Traiter une fois un event ID | Rejouable avec clé autoritative |
Écriture réversible | Créer un brouillon | Retry possible avec compensation |
Écriture irréversible | Email, remboursement, publication | Idempotence forte ou revue humaine |
Résultat inconnu | Timeout après envoi | Lire l’état externe avant retry |
Les clés d’idempotence doivent représenter une intention stable
Hasher les arguments générés par le modèle n’est pas toujours suffisant. Après replay, deux formulations différentes peuvent représenter la même action métier.
Préférez des identifiants stables :
message ID du provider ;
operation ID métier ;
order/payment ID ;
checksum de contenu ;
request ID généré avant le raisonnement du modèle.
Le résultat inconnu est l’état le plus dangereux
Un timeout réseau ne dit pas si le système distant a validé l’action.
Le pattern sûr :
générer un operation ID stable ;
le persister avant l’appel ;
si le résultat est ambigu, lire l’état du système externe ;
rejouer uniquement si l’action n’a pas été effectuée.
Les checkpoints doivent suivre des transitions validées
Le schéma exact dépend du runtime. Le principe reste le même : un checkpoint doit être assez petit pour être compréhensible et assez fiable pour devenir un point de reprise.
Concurrence et versioning de l’état
Deux workers ne doivent pas pouvoir avancer le même run au même moment. Utilisez optimistic locking, leases, locks ou ownership de queue pour garantir qu’une transition ne soit validée qu’une fois.
La mémoire persistante devient un sujet de gouvernance
Une fois la mémoire sortie de la RAM, elle devient une donnée utilisateur conservée.
isolation tenant/utilisateur ;
durées de rétention ;
suppression ;
chiffrement ;
audit ;
règles de promotion en mémoire long terme ;
capacité de correction.
Observabilité et gestion d’état ne sont pas la même chose
Les traces expliquent ce qui s’est passé. La gestion d’état permet de continuer correctement après l’incident.
Un système peut avoir d’excellentes traces mais ne pas savoir rejouer faute d’entrée persistée. L’inverse est également vrai.
Voir observabilité IA.
Un schéma minimal de run state
run : id, owner, input, status, timestamps ;
tool invocation : outil, intention métier, args, status, external ref ;
transition : from, to, reason, version ;
approval : action, approver, décision, timestamp ;
error : type, retryability, trace ref ;
checkpoint : snapshot/version récupérable.
Comment ApowerB a abordé le problème
Le travail de production ApowerB à l’origine de cet article a retenu une règle prudente : persister sessions et entrées de runs, journaliser les outils et éviter le replay automatique lorsqu’un appel précédent rend le résultat incertain.
Cette stratégie refuse volontairement certains replays qui auraient pu être sans danger, afin de privilégier la sûreté jusqu’à ce que l’idempotence des outils soit suffisamment explicite.
Le récit d’incident original est disponible ici : lire le retour DEV.to.
Inspecter comment le runtime persiste et reprend les agents
ApowerB est open source : les chemins de session, run et exécution d’outils peuvent être inspectés directement.
Checklist de gestion d’état
Question | Nécessaire avant replay automatique ? |
|---|---|
L’entrée originale est-elle persistée ? | Oui |
Le propriétaire/tenant du run est-il connu ? | Oui |
Les tool calls sont-ils journalisés côté serveur ? | Oui |
Les outils à effet de bord sont-ils distingués des lectures ? | Oui |
Les écritures critiques ont-elles idempotence ou vérification ? | Oui pour auto-replay |
Les unknown outcomes sont-ils détectables ? | Oui |
Un seul worker peut-il avancer une transition ? | Oui |
Une escalade humaine existe-t-elle ? | Oui |
La rétention mémoire est-elle définie ? | Oui |
Comment cette couche s’intègre au reste
La gestion d’état n’est qu’une couche du runtime. Pour l’architecture globale, voir Agents IA prêts pour la production. Pour les environnements Kubernetes, voir Déployer des agents IA sur Kubernetes.
À retenir
La bonne question n’est pas toujours “où l’agent s’est-il arrêté ?”.
La bonne question est : qu’est-ce qui s’est déjà réellement produit, et qu’est-ce que nous pouvons prouver sûr à rejouer ?
La mémoire conserve le contexte. La gestion d’état protège les conséquences.
Faq
Qu’est-ce que la gestion de l’état d’un agent IA ?
C’est la persistance et la coordination des informations nécessaires pour comprendre, poursuivre, rejouer ou arrêter correctement un run indépendamment du processus actif.
Quelle différence entre mémoire et état d’un agent IA ?
La mémoire conserve du contexte ou des connaissances réutilisables. L’état suit le cycle de vie d’un run précis, ses transitions, outils et actions en attente.
Peut-on reprendre un agent au dernier message LLM ?
Pas toujours. Le chemin peut être probabiliste et des effets externes peuvent déjà s’être produits ; la reprise doit donc s’appuyer sur des transitions validées.
Comment éviter les actions en double après retry ?
Avec des clés d’idempotence stables, un journal d’exécution, la déduplication côté outil, la vérification de l’état externe et une validation humaine lorsque le résultat est incertain.
Où stocker l’état d’un agent IA ?
Dans un stockage durable externe tel qu’une base relationnelle, un durable workflow store ou une autre couche de persistance adaptée au workload.

